Apunte MeetingBaaS a un almacenamiento de objetos que usted posee y cada grabación, transcripción, fragmento de audio y log irá allí. Dos credenciales, una comprobación de acceso de verdad y un relato honesto de lo que se pierde a cambio.
"¿Dónde vive la grabación?" es la pregunta que frena los acuerdos empresariales. Para un banco, un hospital o cualquiera que opere bajo un requisito de residencia de datos, "en nuestros buckets, cifrada" no es una respuesta que puedan llevarle a su equipo de compliance.
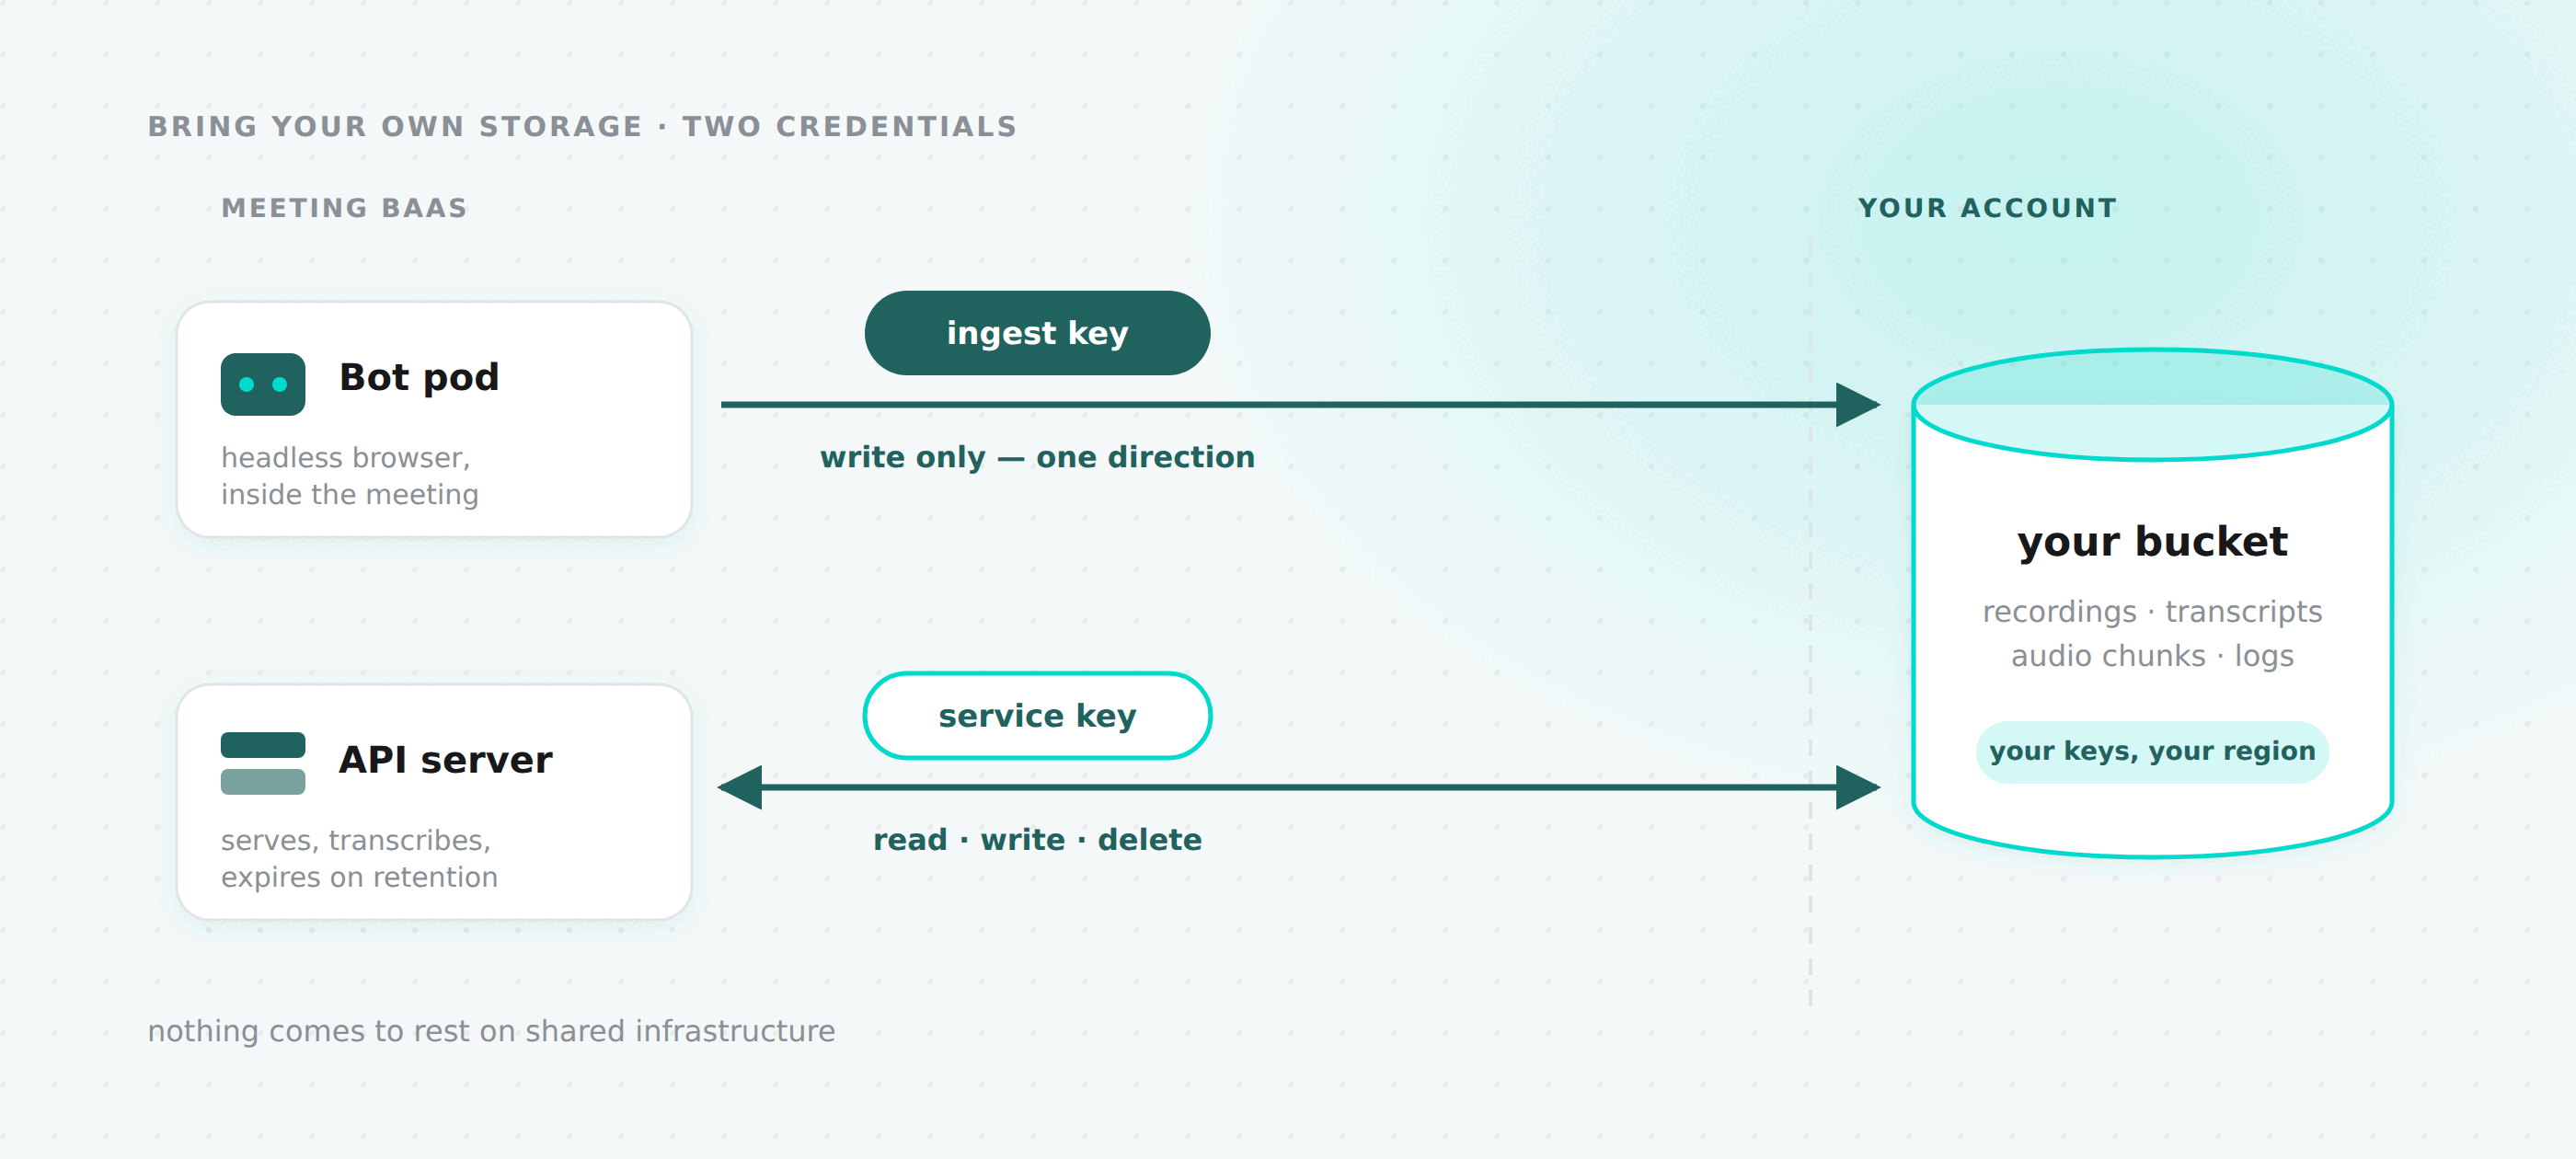
Así que ahora puede darnos un bucket. Cada artefacto que produzcan sus bots a partir de ese momento, grabaciones, fragmentos de audio, transcripciones, capturas de pantalla y logs, se escribe en un almacenamiento que usted posee, con credenciales que usted emitió y puede revocar.
GET    /v2/storage-config          your current configuration, 404 if unset
PUT    /v2/storage-config          set or replace it
POST   /v2/storage-config/test     re-run the access check
DELETE /v2/storage-config          back to MeetingBaaS storage
O bien Configuración (Settings) → Almacenamiento (Storage) en el dashboard, que son esos mismos cuatro handlers detrás de la autenticación de sesión.
Dos credenciales, separadas por dónde terminan físicamente
Esta es la decisión de diseño que defendería con más ganas, así que empiezo por ella.
Usted proporciona dos pares de claves de acceso, no uno:
| Permisos | Dónde reside | |
|---|---|---|
| ingest | PutObject, PutObjectTagging, AbortMultipartUpload | Se le entrega al bot de grabación. Sale de nuestra red. |
| service | GetObject, ListBucket, PutObject, DeleteObject | Solo en nuestro servidor de API. No sale nunca. |
La clave ingest es la única credencial que se acerca a su reunión. Viaja hasta un pod que ejecuta un navegador headless dentro de una llamada, que es el lugar más expuesto en el que podría estar cualquier credencial de este sistema. Puede escribir objetos. No puede leer ninguno de vuelta, no puede listar lo que hay, y no puede eliminar nada. Un pod comprometido puede agregar basura a un prefijo y ese es todo el alcance del asunto.
La clave service hace todo lo demás: servirle de vuelta sus grabaciones a través de URL firmadas, escribir las transcripciones cuando llegan, y eliminar artefactos cuando expira su ventana de retención.
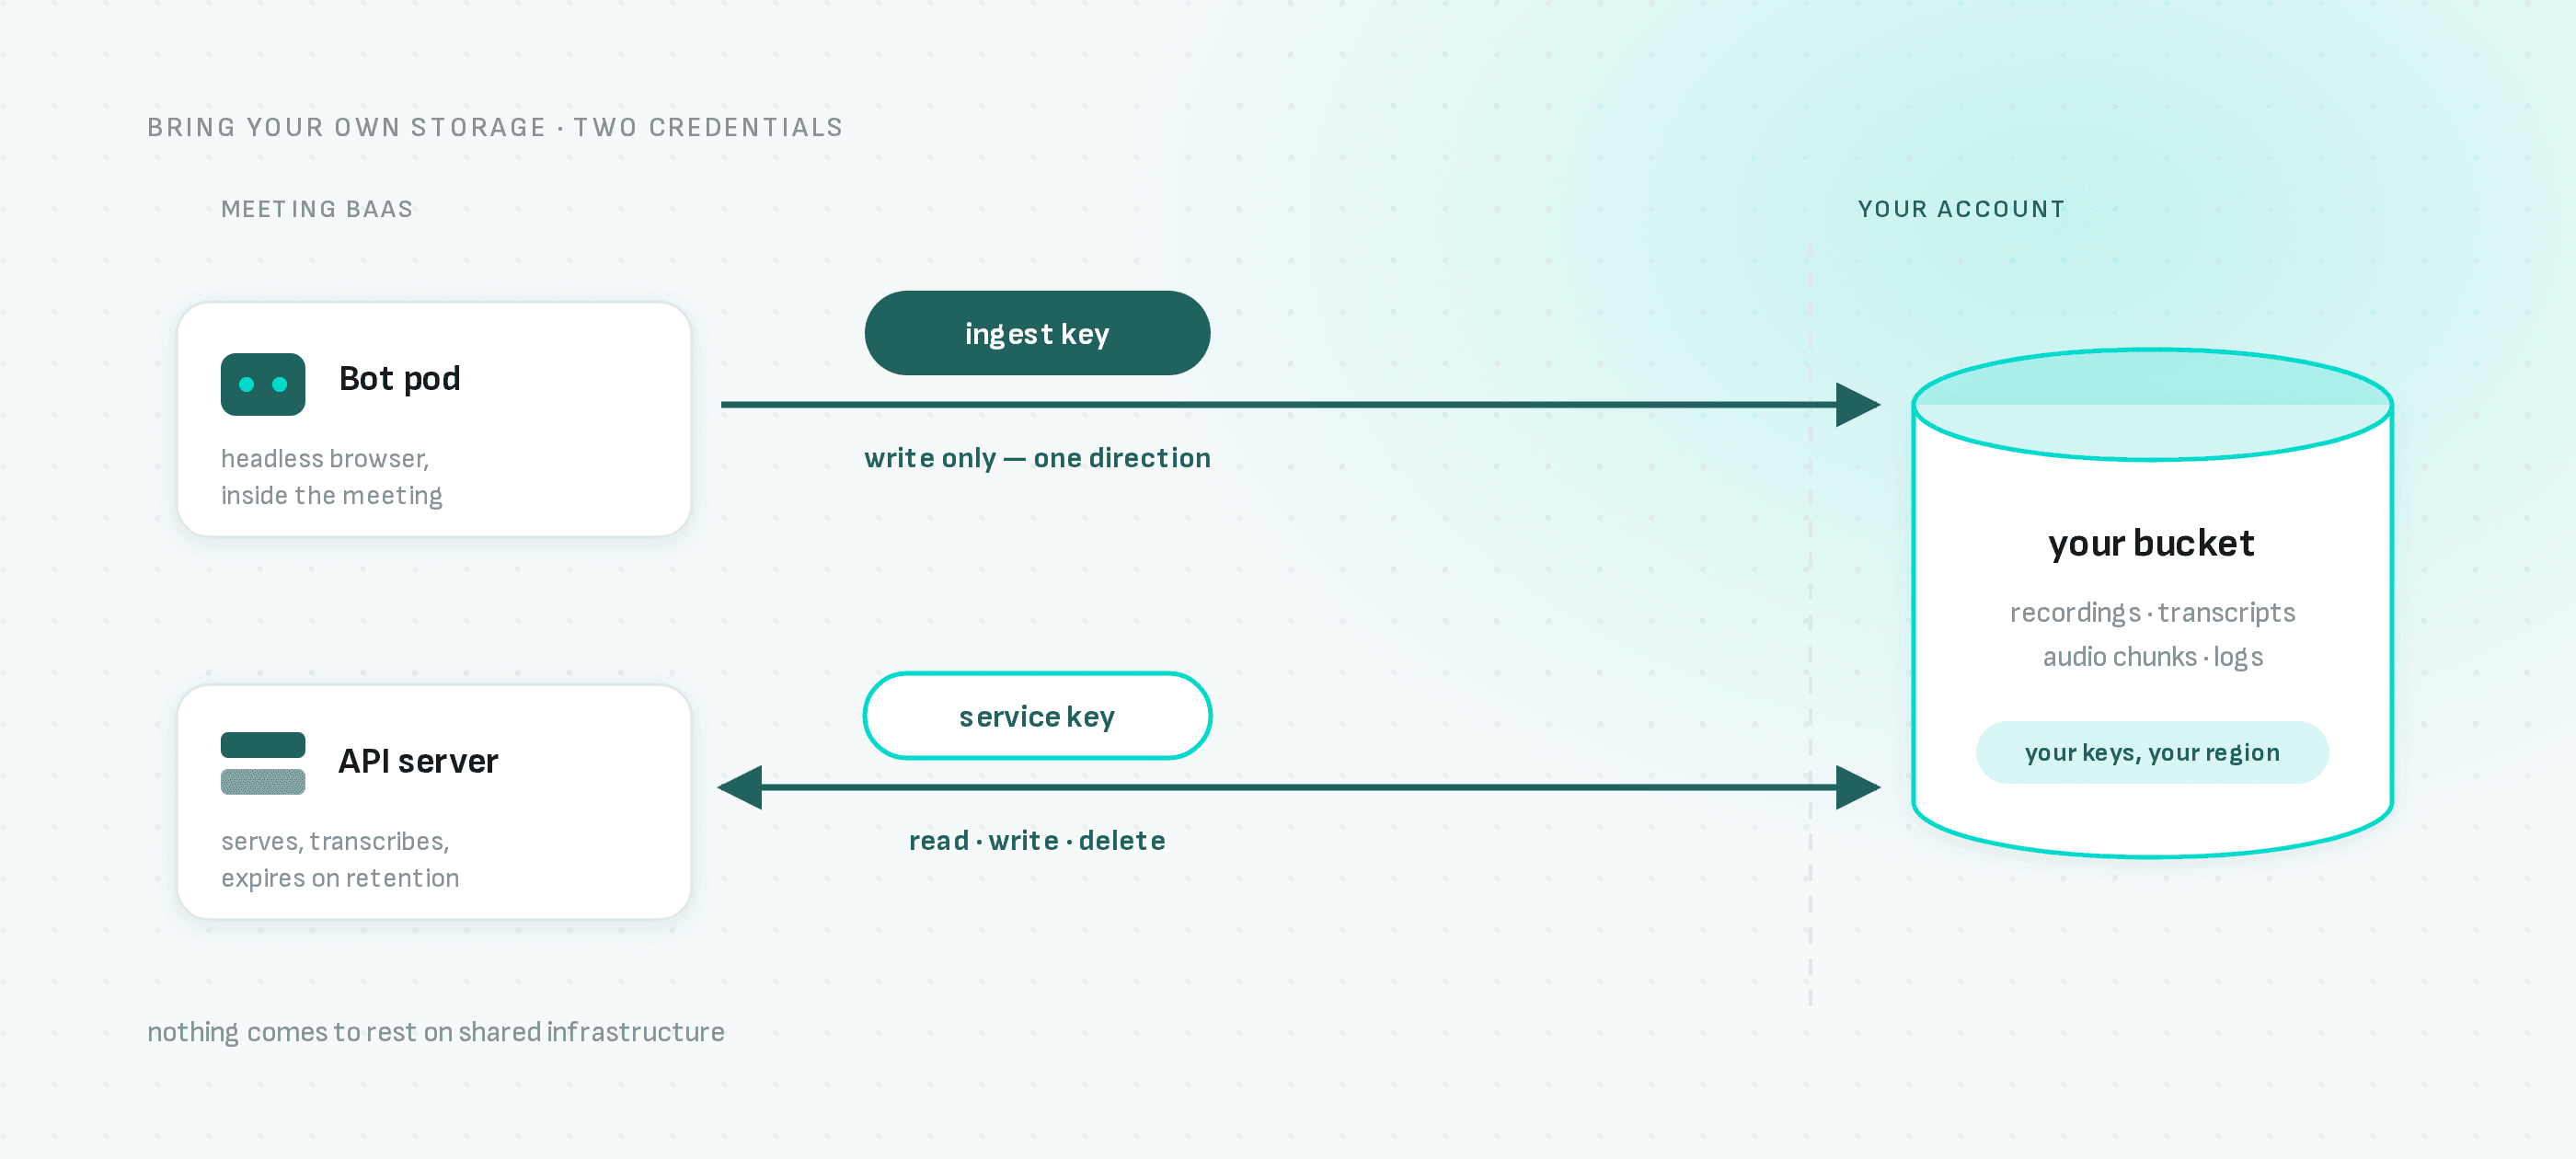
Aquí conviene ser preciso con algo. La clave service no es de solo lectura, y describirla así sería una mentira en la que tarde o temprano nos pillaría. Escribe y elimina, porque la API genuinamente hace ambas cosas. Lo que compra la separación es que la credencial que está en el lugar de riesgo sea la débil. Eso es una reducción real del radio de impacto y no es lo mismo que privilegio mínimo en todas partes, y prefiero decirle exactamente cuál de las dos cosas está recibiendo.
Cómo configurarlo
{
  "endpoint": "https://s3.eu-west-3.amazonaws.com",
  "region": "eu-west-3",
  "force_path_style": false,
  "artifacts_bucket": "acme-meeting-artifacts",
  "audio_chunks_bucket": "acme-meeting-audio-chunks",
  "logs_bucket": "acme-meeting-logs",
  "allow_transient_spill": false,
  "ingest_access_key_id": "AKIAIOSFODNN7EXAMPLE",
  "ingest_secret_access_key": "...",
  "service_access_key_id": "AKIAI44QH8DHBEXAMPLE",
  "service_secret_access_key": "..."
}
Los tres nombres de bucket pueden ser todos el mismo bucket. Las claves de objeto llevan como prefijo el id del bot en cualquiera de los dos casos, así que nada colisiona. force_path_style es lo que necesitan MinIO, Ceph y la mayoría de los gateways autoalojados; AWS y Scaleway funcionan sin él.
El endpoint tiene que ser HTTPS público, sin credenciales ni query string. Los buckets deberían ser privados, ya que los artefactos se sirven mediante URL firmadas de vida corta, pero sí necesitan ser alcanzables desde internet: los proveedores de transcripción obtienen el audio directamente de una URL firmada en lugar de pasar por nosotros como proxy.
Aproveche para permitir el origen del dashboard en el bucket de artefactos. El dashboard descarga los artefactos y lee el JSON de las transcripciones en lugar de enlazarlos directamente, así que son lecturas cross-origin contra su endpoint, y sin una regla CORS el navegador descarta la respuesta antes de que se pueda mostrar nada. GET y HEAD desde el origen de su dashboard es toda la regla. Conviene saber que PutBucketCors está un escalón por encima de los permisos de objeto que tiene la clave service, así que necesita una credencial de nivel propietario: que la clave service devuelva Forbidden ahí es el acotamiento funcionando, no un fallo.
Leer la configuración de vuelta le da ambos IDs de clave de acceso, para que sepa qué credenciales están en uso, y ninguno de los dos secretos. Nunca. Reemplazar una configuración implica volver a introducir ambos secretos, porque no podemos mostrarle lo que hay.
La comprobación de acceso, y por qué no es un trámite
PUT verifica la configuración antes de almacenarla. Y no llamando a ListBuckets y dándolo por bueno.
La clave ingest escribe un objeto marcador en cada bucket distinto. Después la clave service lee ese objeto, lo escribe y lo elimina.
Cada verbo lo ejercita la credencial que realmente lo va a ejecutar en producción, así que la sonda falla igual que fallaría producción. Los cuatro son críticos: la subida con ingest es cómo llegan las grabaciones, la subida con service es cómo se escriben las transcripciones, la lectura es cómo se sirven los artefactos, y la eliminación es cómo la retención hace expirar algo de verdad.
La parte realmente útil es separar la escritura de la lectura. El marcador lo escribe una credencial y tiene que encontrarlo la otra. Eso detecta el fallo que nadie prueba: dos pares de claves perfectamente válidos cada uno, pero apuntando a buckets distintos o a cuentas distintas. Cualquier health check del mundo hecho con una sola credencial da por buena esa configuración, y después usted pierde una grabación.
Sin esto, la primera señal de un nombre de bucket mal escrito es una subida fallida al final de una reunión real, cuando el disco local del pod ya no existe. Cuando la comprobación falla, mostramos el mensaje del propio proveedor tal cual en lugar de un error genérico, porque "la clave ingest no puede escribir en el bucket de artefactos" es todo el valor de ejecutarla.
Puede volver a ejecutarla cuando quiera con POST /v2/storage-config/test, que es lo que le interesa después de rotar claves o cambiar una política de bucket.
Una cosa que deliberadamente no puede detectar: CORS. La comprobación se ejecuta desde nuestros servidores, donde CORS no aplica, así que un bucket puede superar todos los verbos anteriores y aun así negarse a entregar una grabación a un navegador. Ese hueco nos toca cerrarlo a nosotros, y hasta entonces, la nota sobre permitir el origen del dashboard es lo que separa una comprobación en verde de un dashboard que no muestra nada.
La invariante de la que se deriva todo lo demás
Un bot siempre resuelve hacia el almacenamiento en el que fue escrito, nunca hacia aquel con el que su equipo esté configurado hoy.
Cuando se despacha un bot, la configuración de almacenamiento vigente en ese momento queda estampada en el registro del bot. Cada lectura, cada URL firmada y cada eliminación de ese bot se resuelve a través del sello. No a través del equipo.
Eso suena a detalle de implementación. Es la razón por la que se puede activar esta función sin riesgo, y de ahí se derivan directamente cuatro consecuencias:
Cambiar su configuración inserta una fila nueva y deshabilita la anterior. Nunca se actualiza en el sitio. Mutar la fila redirigiría en silencio los artefactos de todos los bots existentes a un bucket donde no existen.
DELETE /v2/storage-config solo cambia una bandera. No se elimina nada, en ninguno de los dos lados. Un borrado duro quitaría las credenciales que los bots antiguos todavía necesitan y dejaría huérfana cada grabación de su cuenta.
La resolución ignora deliberadamente si una configuración está habilitada. Deshabilitarla detiene el envío de nuevos artefactos a su bucket. No debe dejar huérfanos los que ya están ahí.
Una configuración estampada que no se puede encontrar lanza un error en lugar de recurrir a nuestros buckets. Recurrir a ellos reportaría sus artefactos como faltantes, y en una eliminación por retención dejaría sus datos atrás en silencio mientras reporta éxito. Fallar en voz alta es el comportamiento correcto.
La versión práctica: configúrelo, cámbielo o quítelo cuando quiera. Las grabaciones antiguas siguen funcionando durante todo eso. Lo único que vuelve ilegibles los artefactos antiguos es revocar nuestro acceso de su lado, que es su decisión y funciona exactamente como esperaría.
El intercambio que realmente está haciendo
allow_transient_spill es false por defecto para los equipos con su propio almacenamiento, que es lo contrario de nuestro valor predeterminado de plataforma. Esto es lo que significa, en su totalidad, porque es el único punto en el que esta función le cuesta algo.
Normalmente, cuando una subida falla, replicamos el artefacto en nuestro propio volumen de red y un trabajo de reconciliación lo empuja más tarde. Ese camino copia la reunión entera: el video, el audio, la salida de diarización, cada fragmento. A nuestra infraestructura, en nuestra cuenta.
Que es exactamente lo que un cliente de residencia contrató para evitar. Peor aún, los clientes de residencia caen en ese camino más que los clientes de plataforma, porque su bucket está fuera de nuestra red y a menudo en un proveedor completamente distinto.
Así que con allow_transient_spill: false, el respaldo queda desactivado en todos los tipos de bot y en el consumidor. Una subida que agota sus reintentos se reporta como fallida, y el artefacto se pierde.
Ese es el intercambio: durabilidad a cambio de residencia. Lo compensamos en parte dándole al cliente de subida del bot seis intentos en lugar de los tres predeterminados del SDK, para que un bache no le cueste una grabación, pero una caída sostenida de su bucket todavía se la va a costar.
Póngalo en true si prefiere conservar la grabación antes que mantener la garantía. El dashboard muestra una advertencia que explica con precisión a qué está renunciando cuando lo cambia, porque no debería ser una casilla que se marque de pasada.
Si desaparecen grabaciones y su bucket tuvo una caída, eso es lo primero que hay que revisar.
Lo que esto no hace
Cuatro cosas, dichas por adelantado para que nadie las descubra después.
No se mueve nada de lo ya grabado. No hay migración. Cada bot sigue resolviendo hacia donde fue escrito, que es lo que hace seguro activar esto, y también significa que su historial se queda en nuestros buckets.
No hay configuración de prefijo por bucket. Las claves son <bot_uuid>/… y eso es fijo.
Esto no hace hermética la residencia por sí solo. Los pods de bot siguen guardando la grabación en disco local mientras la reunión está en curso. Lo que cierra es el único camino por el que su grabación llega a reposar en infraestructura compartida de MeetingBaaS.
Los assets del dashboard se quedan en nuestros buckets. Los logos, los avatares de usuario y los adjuntos de soporte no son datos de reuniones y no están cubiertos.
Cómo revertirlo
DELETE /v2/storage-config, seguro en cualquier momento. Los bots nuevos vuelven a nuestro almacenamiento de inmediato. Los bots existentes siguen resolviendo hacia sus buckets y siguen funcionando.
Relacionado
- Seis proveedores de transcripción, una sola API — combine la región de un bucket con la región de un proveedor para lograr residencia de extremo a extremo
- Autoalojar Meeting BaaS — si ser dueño del bucket no llega lo suficientemente lejos
- Referencia de la API de Meeting BaaS
Si está resolviendo un requisito de residencia y quiere saber exactamente qué componentes tocan qué, pregúntenos. Le daremos la misma respuesta que dimos aquí.